 Huili Yu

周年庆结束,账单却没降
我们团队负责一款中重度手游的数据中台与埋点分析。周年庆期间,最忙的除了游戏业务网关和微服务,还有实时活动指标看板。
活动期间,运营需要实时掌握限时礼包的转化率、买量渠道引入的新增玩家表现,以及关卡流失节点。为了保证分钟级的决策时效,我们将原本整点批处理的活动监控任务,提升至每 15 分钟聚合一次,Databend Cloud 底层的计算集群(warehouse)可以按需弹性扩展。
这笔开销在活动期间完全合情合理。几个小时的数据延迟,可能就会让运营团队错失调整买量预算或修正掉落策略的黄金窗口。周年庆结束后,玩家活跃与打点事件量迅速回落。团队正忙着准备留存与收入大盘复盘,费用问题也跟着来了:“活动已经结束一周了,湖仓费用为什么还在高位?”
我第一反应是查监控大盘:没有堆积的失败任务,没有显著的慢查询告警,核心收入与留存报表全部按时产出。
以往遇到这种“无报错性成本异常”,排查极为繁琐:需要跨账单计量(billing)、查询日志(query history)、调度系统(task runs)去写大量关联复杂的元数据分析 SQL。同时,我也绝不能盲目为了降本直接缩容 warehouse 或停掉一批任务——活动后的留存回溯和对账任务还在跑,停错一个,费用问题就会升级为报表延迟与数据事故。
这次我打开了 Databend Cloud 控制台右下角的 Cloud Agent 来帮我定位问题。Cloud Agent 是内置在 Databend Cloud 控制台里的 AI 引擎。它能将自然语言转化为透明可审计的系统查询,自主完成跨维度的关联分析与图表呈现;涉及资源变更时,则严格遵循只读、确认的双重权限边界。
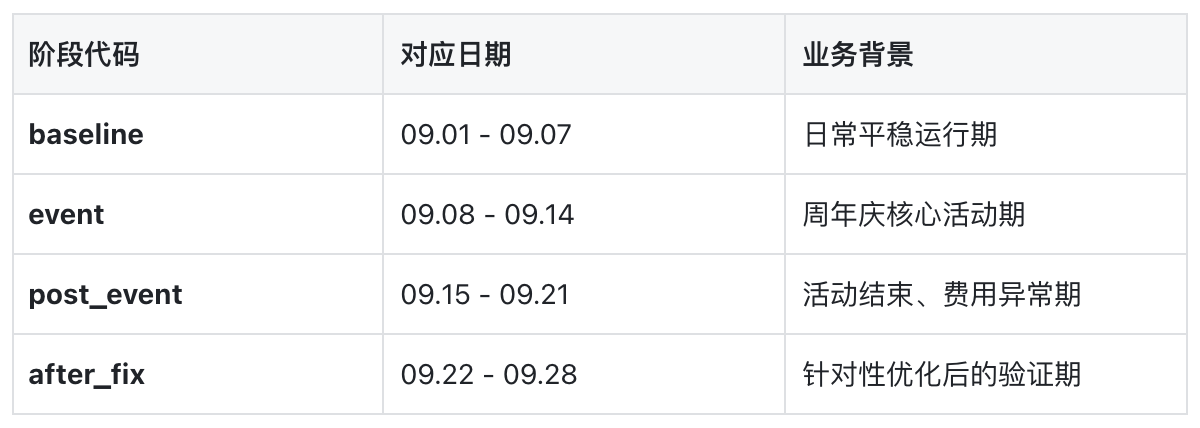
为了清晰说明问题,本文隐去真实账单金额,将日常费用基准设为 100 指数。我们划分了四个典型的对比阶段:
第一问,成本真的和业务量脱钩了吗?
要找财务沟通,第一步必须用数据证明异常窗口,确认成本与业务量何时发生了断层。我先向 Cloud Agent 发问:
比较 9 月 1 日到 28 日的 DAU、事件量和总成本指数。按四个阶段计算平均值,找出业务量已经回落、成本仍然偏高的时间段。先确认异常发生在哪里,不要继续判断根因。
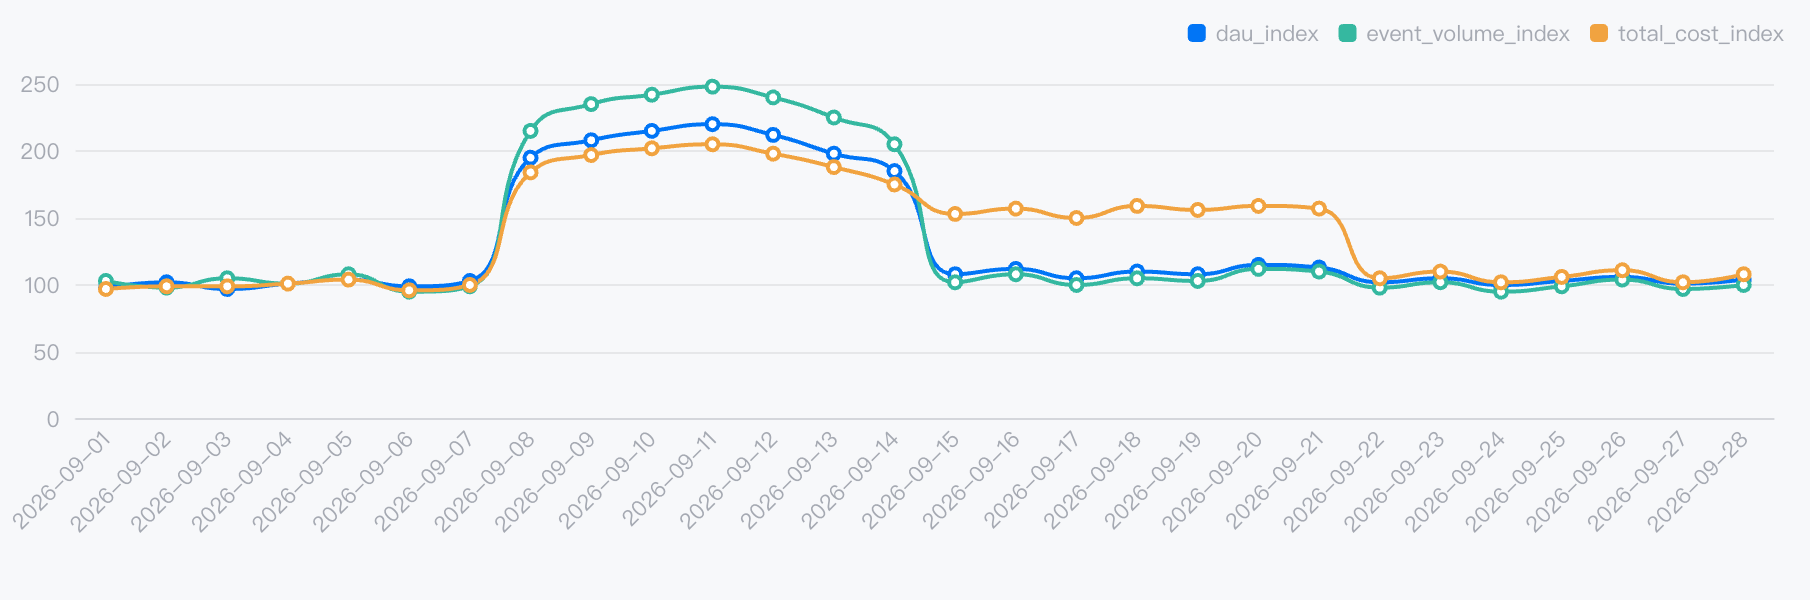
DAU、事件量与总成本指数趋势
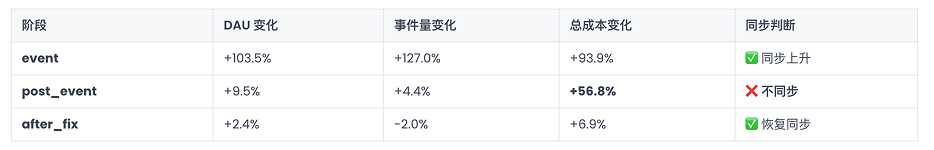
相对于 baseline 的百分比变化
图里的断层很清晰。
event
post_event
异常窗口被精准锁定在 9 月 15 日到 21 日。这确认了业务与成本脱钩的事实,具体是哪部分资源在耗费?
第二问,多出来的成本究竟来自哪里?
现代湖仓通常由计算、对象存储、数据网络、导入等多个账单分项构成。第二轮对话,我让 Agent 对成本结构进行了拆分:
比较
和
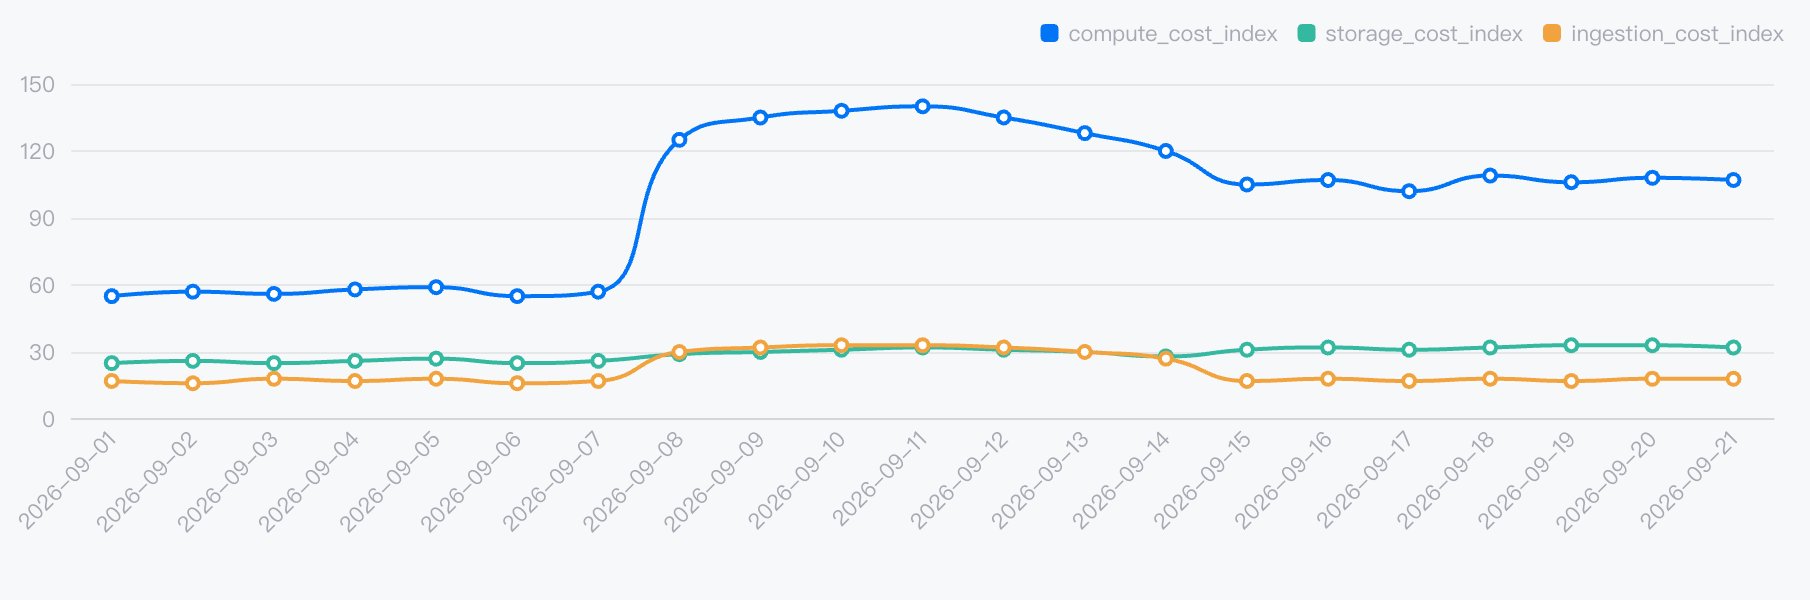
成本分项趋势:计算、存储、数据导入
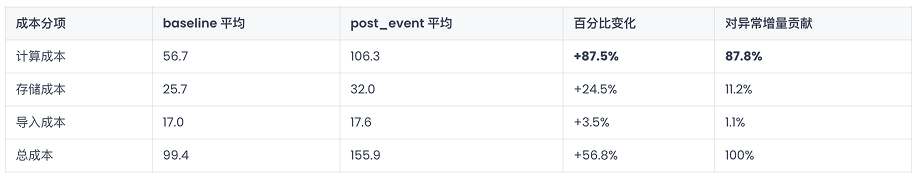
精简对比表
分析给出了明确答案:
post_event
疑点被收窄到计算侧。在存算分离架构中,单次查询快不快不是关键,累计空跑的高频任务与无谓的数据扫描量,才是吞噬成本的隐形杀手。
第三问,哪个任务还按活动节奏运行?
接下来需要排查具体的调度任务。我让 Cloud Agent 关联查询历史与任务配置,从运行频次、数据扫描量、查询指纹(
query_fingerprint
比较各任务在
、
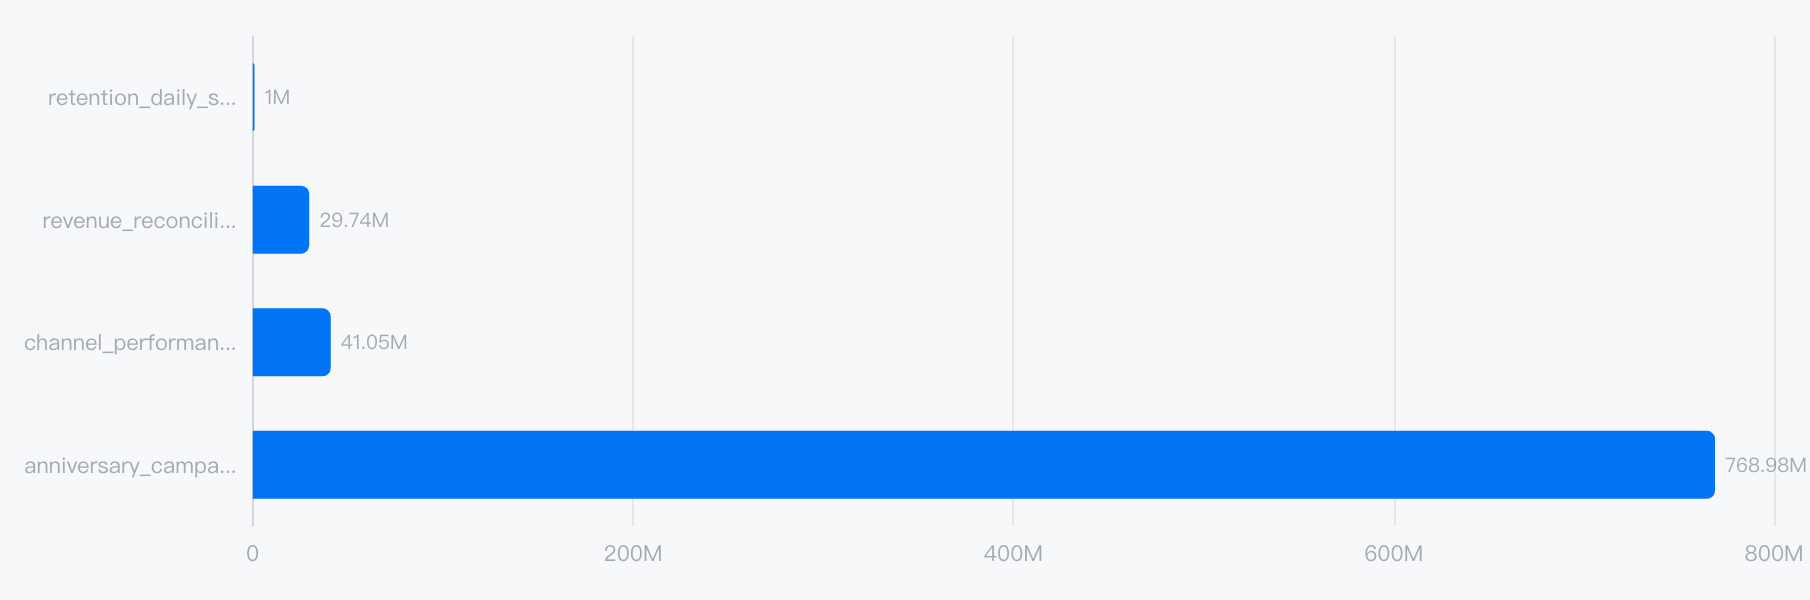
post_event 阶段各任务扫描量占比
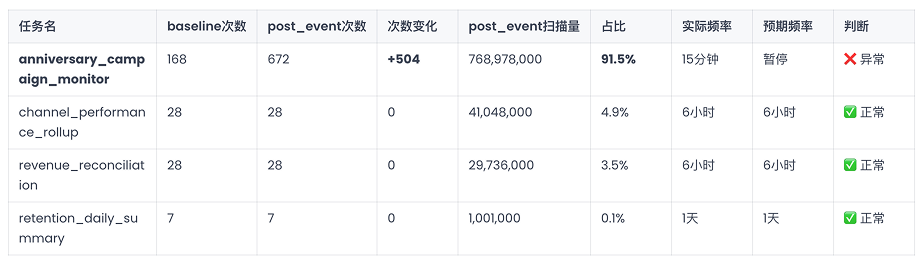
精简证据表
名为
anniversary_campaign_monitor
日常阶段该任务每周执行 168 次(每小时 1 次);活动期间为了准实时看数,被调成每 15 分钟 1 次;而在活动结束后的
post_event
扫描量给出了另一条证据。这个任务在
post_event
post_event
active=true
监控没有报警的原因也在这里。任务没有失败,它只是继续做一件已经不需要如此频繁去做的事。成功率只能说明任务跑完了,不能说明这次运行仍有业务价值。
找到任务后,先别急着停
查到
anniversary_campaign_monitor
我让 Cloud Agent 输出暂停前的风险评估报告,把客观事实、依赖风险与人工确认项拆解开:
评估暂停
的影响。区分数据能够直接证明的事实、当前无法验证的依赖风险和暂停前需要人工确认的事项。先给方案,不要执行变更。
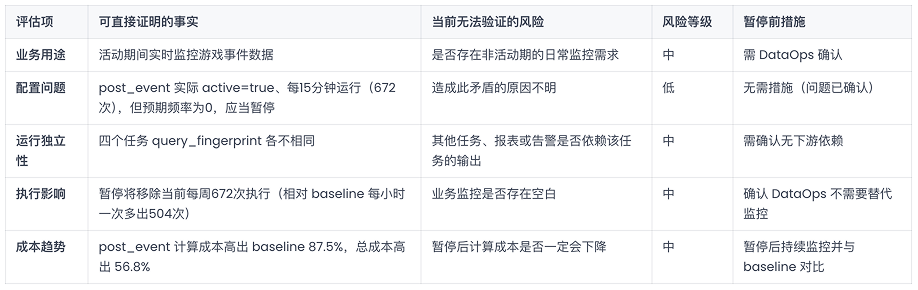
暂停影响评估
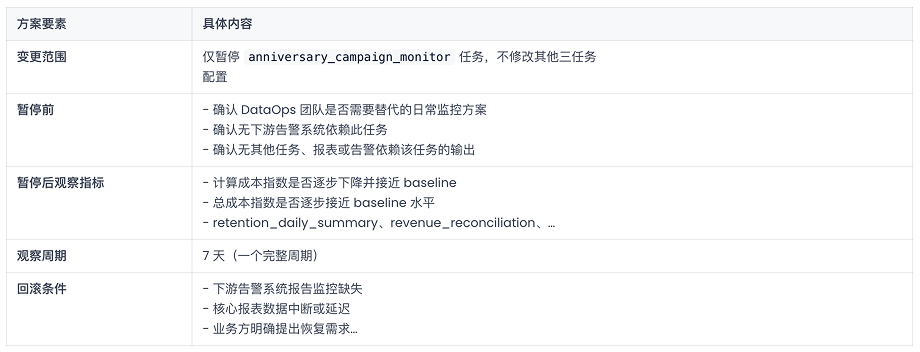
低风险处理与回滚方案
Cloud Agent 梳理出的方案比较稳妥:首先是明确边界,只处理目标任务,保留关键的留存日报、收入对账与渠道汇总。暂停后观察计算成本、总成本、三项必要任务的状态和报表新鲜度。如果遇到告警缺失、报表中断或业务方要求恢复,都会触发回滚。
在与相关业务 DataOps 同学快速二次确认后,这项活动监控没有非活动期的日常需求,也没有发现已知的下游报表或告警依赖。我请 Cloud Agent 只暂停
anniversary_campaign_monitor
第四问,成本降下来,报表变慢了吗?
对于数据团队来说,降本从来不能以牺牲数据 SLA 为代价。修复完成后的周期验证,必须双向核对成本与服务质量:
比较
和
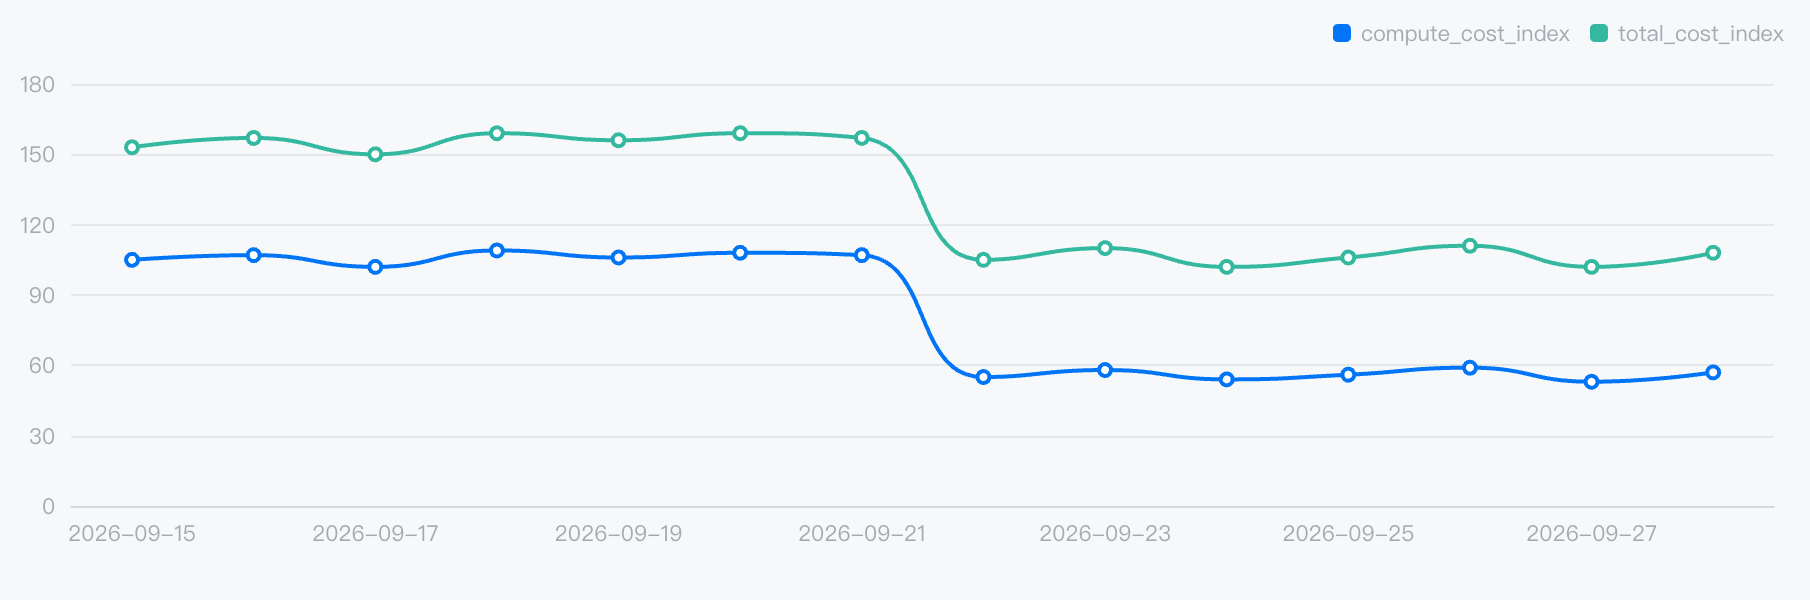
成本与报表新鲜度趋势
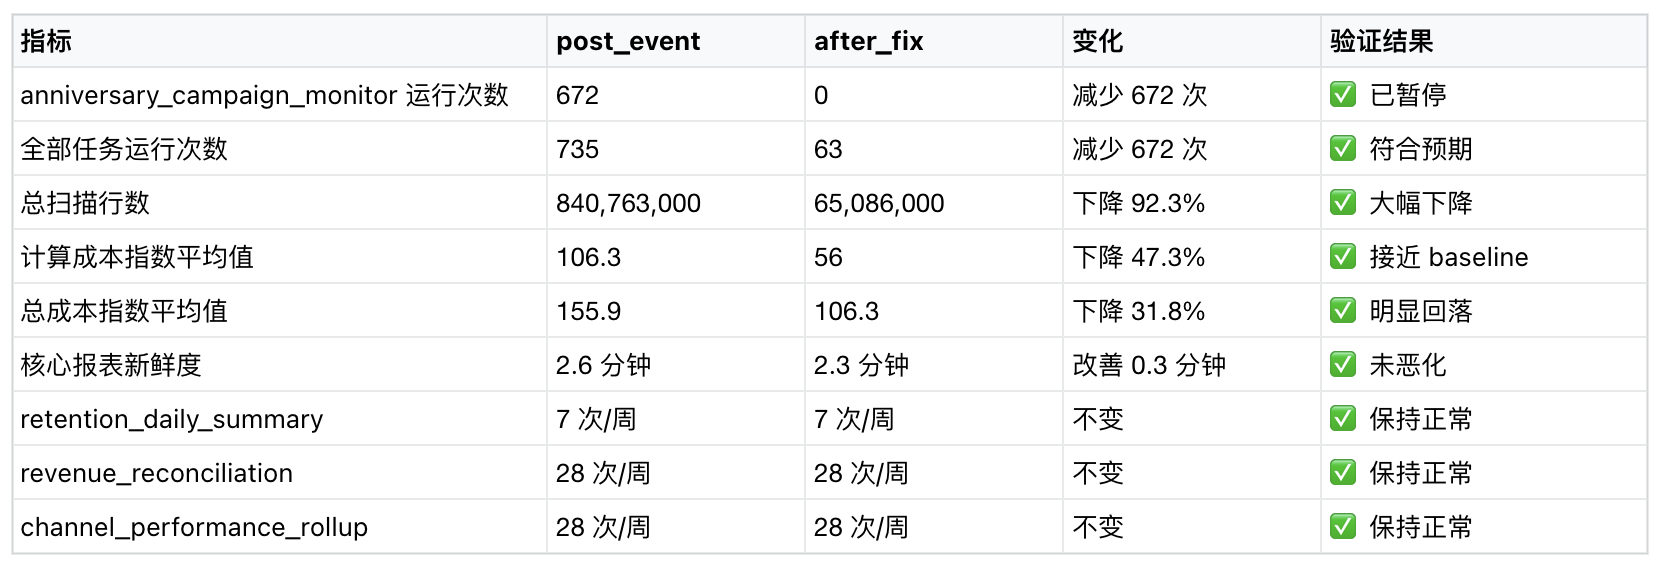
数据给出了令人满意的闭环反馈:
-
目标任务运行次数从 672 次降为 0;
-
湖仓总扫描行数从 8.4 亿骤降至 6500 万行(降幅 92.3%);
-
计算成本指数从 106.3 降至 56,回落至日常基准水位;湖仓总账单下降 31.8%;
-
核心生产任务未受任何影响:留存日报仍为每周 7 次,对账与渠道汇总仍为每周 28 次;
-
核心大盘报表的新鲜度(更新延迟)从 2.6 分钟缩短至 2.3 分钟,完全没有受损。
从经验排障走向透明的 FinOps
这几轮对话里,我都没有写 SQL。我用自然语言让 Cloud Agent 完成趋势比较、成本拆分、任务归因、风险评估和修复验证。这套交互对不熟悉 SQL 的人很友好。运营、产品和其他业务团队也能用同样的方式工作。他们可以直接询问活动参与、渠道转化、付费留存和异常波动,让 Cloud Agent 在权限范围内查询数据,生成表格与图表,再围绕结果继续追问。
在过去,一次活动后的成本异动排查,往往需要耗费不少精力。而这次排障的核心体验可以概括为两点:
-
让数据工程师摆脱重复的劳动:自然语言不仅省去了手写复杂审计 SQL 的时间,更关键的是让思考过程保持连贯——从异常初筛、成本构成拆解、任务指纹定位,一路追问到风控与效果回测。
-
逻辑可溯与生产级安全边界:对于 DE 而言,最担心的往往是 AI 的“黑盒化”与“幻觉操作”。Databend Cloud Agent 的每一次交互支持随时查看背后的实际执行逻辑。同时,只读分析与生产变更严格隔离,涉及配置变更有明确的审批与权限阻断机制,兼顾了敏捷与安全。
从你的问题开始,体验 Cloud Agent
Databend Cloud Agent 是内置于 Databend Cloud 控制台的 AI 助手。它可以用自然语言查询和分析数据、生成图表、查看查询历史与数据血缘,也能协助管理 warehouse、task、flow 和数据管道。账单场景中,它可以查看余额、月度费用、每日明细和账单历史,并完成趋势与归因分析。
Cloud Agent 目前处于 Preview 阶段。打开 Databend Cloud 控制台左侧菜单或者右下角的 Cloud Agent 图标,即可开启对话,比如“最近的账单有什么变化”或者“哪个任务在活动结束后仍然高频运行”。
更多能力和使用方式,请参阅 Cloud Agent 产品文档。
订阅我们的新闻简报
及时了解功能发布、产品规划、支持服务和云服务的最新信息!