 DatabendLabs

更新概览
2026 年 8 月至 9 月 Databend 产品更新围绕这些使用链路展开。物化视图和 Dynamic Table 补充了分析结果持久化与复用能力,Data Sharing 扩展了跨租户读取和独立增量消费,数据血缘提供了对象级与列级的来源和影响查询。查询性能、资源管理与运行稳定性方面也有多项改进。
,2026 年 8 至 9 月,Databend 主仓库共发布以下版本:
-
20 个 nightly 版本:从
到v1.2.931-nightly。v1.2.950-nightly -
2 个 patch 版本:
、v1.2.925-patch-6。v1.2.925-patch-13
nightly release notes 中的 PR 条目按编号去重后,共计 272 项发布变更。
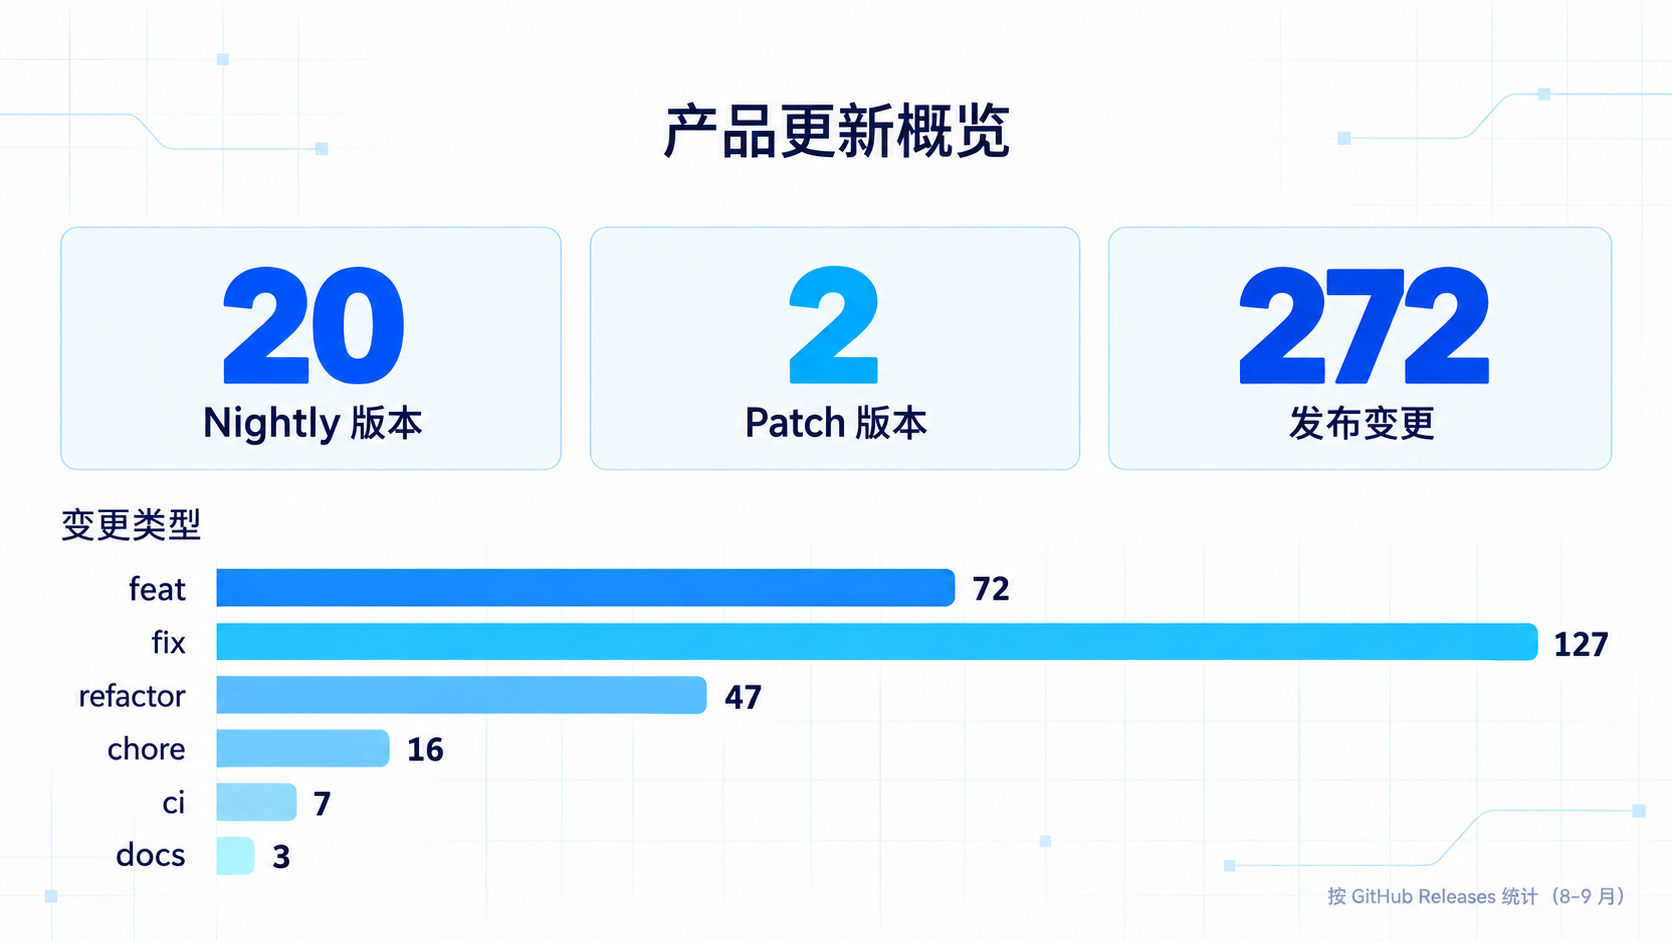
统计说明:上述数据反映发布版本包含的变更,不等同于本期合并的 PR 数量。
包含内部工具增强,
物化视图|减少重复计算,简化结果维护
Materialized View(物化视图) 通过持久化查询结果或中间聚合状态,减少重复计算。相较于仅保存查询定义的普通 View,物化视图需要同时处理源数据变更、结果刷新、读取一致性与查询改写。
本期围绕上述环节继续完善物化视图的使用与维护方式。
变更跟踪与混合读取
物化视图基于源表的
CHANGE_TRACKING
REFRESH MATERIALIZED VIEW
-
追加数据 支持增量刷新。
-
非聚合物化视图 利用内部源行标识处理更新和删除。
-
聚合物化视图 保存聚合状态,支持合并已有状态与追加数据的状态。源表发生更新或删除时,刷新仍可能需要全量重算。
-
Hybrid Reads(混合读取) 支持在追加场景下结合持久化结果与尚未刷新的源表增量,降低对全量扫描的依赖。
自动改写与日常维护
优化器新增物化视图查询改写规则、
enable_materialized_view_rewrite
维护方面,物化视图支持聚簇键、recluster、compact、索引和
system.materialized_views
以下示例基于持续追加的销售表,创建按类别聚合的物化视图:
CREATE TABLE sales (
  category STRING,
  amount INT
) CHANGE_TRACKING = TRUE;

CREATE MATERIALIZED VIEW mv_sales (
  category,
  total_amount
)
CLUSTER BY (category)
AS
SELECT category, SUM(amount)
FROM sales
GROUP BY category;

REFRESH MATERIALIZED VIEW mv_sales;

SELECT * FROM mv_sales;
适用范围:物化视图属于 Databend Enterprise Edition 能力,需要相应授权。当前以启用了
CHANGE_TRACKING
用分批刷新控制单次维护量
9 月新增刷新批量提示:
REFRESH MATERIALIZED VIEW mv_sales LIMIT 100000;
LIMIT
Dynamic Table:支持多表派生结果的全量刷新
本期新增支持全量刷新的 Dynamic Table。该能力采用独立的、基于 Fuse 的表引擎,面向多表派生结果,通过
REFRESH DYNAMIC TABLE
与物化视图不同,Dynamic Table 查询读取上一次刷新后的持久化结果,结果可能落后于源数据。本期能力不包含自动调度、自动增量刷新或物化视图式的新鲜度补偿。
选型时,应结合查询来源与数据新鲜度要求:单表结果复用和查询改写可评估物化视图;多表派生结果、且可接受显式刷新间隔的场景可评估 Dynamic Table。
数据共享丨支持跨租户访问与独立增量消费
Data Sharing(数据共享) 支持不同租户在保留各自数据处理空间的同时,基于提供方的同一份源数据开展协作。
对于跨团队或跨租户的数据消费需求,传统方式通常依赖数据导出、复制与同步任务。通过 Data Sharing,提供方可将选定的 Fuse 表加入 Share 并授权指定消费方;消费方在本地建立只读数据库绑定,直接查询共享对象,无需先复制整张源表。
从提供方授权到消费方读取
一个 Share 暴露一个数据库及其中选定的 Fuse 表。提供方管理共享对象和租户授权,消费方通过本地数据库名访问共享数据。存储访问通过 Provider Connection 解析,提供方凭据不会直接复制至消费方的数据库绑定。
以下为配置 Provider Connection 后的 SQL 结构示例。
<provider_connection>
<consumer_tenant>
<provider_tenant>
-- 提供方:创建共享,授权数据库、表和消费租户
CREATE SHARE sales_share CONNECTION = <provider_connection>;
GRANT USAGE ON DATABASE sales TO SHARE sales_share;
GRANT SELECT ON TABLE sales.orders TO SHARE sales_share;
ALTER SHARE sales_share ADD ACCOUNTS = <consumer_tenant>;

-- 消费方:建立只读数据库绑定
CREATE DATABASE shared_sales FROM SHARE <provider_tenant>.sales_share;
SELECT * FROM shared_sales.orders LIMIT 10;
共享关系绑定稳定的 Share、数据库和表 ID。对象重命名后可保留对原对象的访问;删除后重建同名表,不会自动继承旧表的共享授权。提供方可通过撤销表授权或移除消费账号,控制后续共享访问。
共享表的独立 Stream 消费
9 月新增在共享表上创建消费方本地 Stream的能力。提供方开启
CHANGE_TRACKING
该能力适用于基于共享业务明细构建本地报表、派生表等场景。不同消费方可按各自的处理周期消费增量,无需共用消费进度。具体数据管道仍需配置消费和处理任务,Stream 本身不自动完成数据同步。
适用范围与限制
-
支持同一 Databend Meta 集群内的跨租户共享,不支持任意独立部署之间的跨集群共享。
-
当前共享对象为选定的 Fuse 表。消费方仅可读取,不能修改源表或再次共享该数据库。
-
带有行访问或列脱敏策略的提供方表,目前不支持直接跨租户共享。
-
Stream 依赖提供方开启 change tracking;消费方删除并重建共享数据库后,原有 Stream 将失效。
-
Data Sharing 属于 Enterprise Edition,需要
授权。DataSharing
通过提供方授权、消费方只读访问与独立增量消费,Data Sharing 扩展了跨租户数据协作的能力范围。
数据血缘丨支持对象级与列级依赖追溯
数据血缘通过提取执行计划中对象与列之间的数据流关系,并聚合成功执行的查询历史,支持数据来源追溯与下游影响分析。
本期提供两类查询入口:
-
:查询上游来源或下游消费对象,支持对象级和列级血缘,遍历距离为 1–5 跳。GET_LINEAGE
-
:查询直接相连的对象,适用于血缘图的逐层展开。GET_LINEAGE_NEIGHBORS
-- 查询结果表的上游对象
SELECT *
FROM get_lineage('default.analytics.sales_summary', 'TABLE', 'UPSTREAM', 3);

-- 查询直接相邻的对象
SELECT *
FROM get_lineage_neighbors('default.analytics.sales_summary', 'TABLE');
血缘关系采用统一的
source -> target
query_id
本期还扩展了已有 View 的血缘刷新、显式 materialized CTE 的血缘提取、物化视图血缘,以及基于绑定后计划的关系捕获。
使用限制:历史采集与聚合采用异步、best-effort 机制,启用前的历史数据不会自动补录,日志或历史处理失败也可能造成缺失,因此不能将血缘结果视为完整审计记录。列级血缘关注对输出值有贡献的列,不包含 SQL 中的全部过滤、连接或排序依赖。使用前需确认历史表配置与 SystemHistory 授权。
该能力可用于异常指标溯源、表结构调整前的影响分析,减少对人工维护依赖关系的依赖。
扫描与存储优化丨分区、TopN 与索引
让 Fuse 分区布局更明确
Fuse 新增
PARTITION BY
现有未分区表可通过
ALTER TABLE ... PARTITION BY (...)
配套的 hash-distributed partition writes 支持按哈希分发分区写入,并修复了分区布局与聚簇布局隔离、写入合并等相关问题。
减少 TopN 查询的扫描量
新增 fused TopN operator 和 runtime scan filters,利用排序过程中形成的当前边界过滤扫描。本期同时支持块读取时重新检查 TopN 边界、typed virtual columns 的 TopN pruning,以及 aggregate rank limit 边界下推。
相关改进主要面向排序取前 N 条、排名等分析场景,减少读取量和中间处理开销。实际收益取决于数据布局、过滤条件与执行计划。
优化器统计同步完善了
UNION ALL
全文检索与多维聚簇
-
倒排索引新增日语分词器,扩展多语言检索能力。
-
索引写入随数据块构建进行;索引段合并可避免重新分词,并减少对象存储请求。
-
ngram bloom 索引优化构建路径。
-
Hilbert clustering新增元数据、统计及 reclustering 支持,采用新实现,不保留上一期已移除的 legacy 实现。
-
Recluster 支持并发任务,并优化排序、合并任务的组织方式与诊断开销。
稳定性丨完善资源回收、内存控制与执行正确性
本期修复主要集中于以下几个方面:
查询取消与资源回收。 完善同步 spill processor、hash join stream 的可中断性,修复 Flight exchange 关闭后的任务停止、receiver 提前退出时的 hash exchange 阻塞,以及下游完成后的 spill 阻塞问题。针对客户端断开、查询取消或仅需部分结果的场景,提升任务停止与资源回收的可靠性。
内存控制。 优化最终聚合完成阶段的内存边界、Window 输出期间的 spill、窗口缓冲前的未使用列裁剪、Parquet row group 字节限制、按选中行数分配解码缓冲,以及 Vacuum GC 的流式处理和根节点内存控制,减少峰值内存开销。
执行语义与结果正确性。 修复 nullable correlated/lateral join key、分布式时间函数一致性、Window
RANGE INTERVAL
派生结果与历史数据生命周期。 修复 change tracking 计数重置后的正确性、物化视图刷新与改写检查,避免活跃临时表和进行中的 CTAS staging 表被 vacuum,并在 time travel 快照缺失时返回明确错误。
测试方面,引入 type matrix、metamorphic testing 和 table-kind × write-path 矩阵,扩大不同类型、表引擎与写入路径组合下的回归覆盖范围。
治理、运维与生态更新
行级 TTL 定义与元数据支持
本期新增行级 TTL 的 DDL 与元数据支持,可定义、修改和移除 TTL 表达式。
该阶段能力为数据生命周期管理提供基础,尚未包含后台调度和过期行删除。配置 TTL 表达式后,数据不会自动过期删除。
Meta 通信、通知与任务配置
Databend-meta 继续完善通信与认证能力。本期引入 Raft 协议 secret 和兼容模式支持,并新增 Raft peer TLS 与可配置的 gRPC 握手认证。多组凭据可在轮换期间重叠使用,便于在不中断服务的情况下完成凭据更新。Meta 管理工具统一采用
--user
--password-file
上述能力需要配套配置证书、认证策略与升级顺序。版本升级本身不会自动加密全部 Meta 通信。
通知配置新增
WEBHOOK_BODY_TEMPLATE
Task 新增在定义阶段解析常量
EXECUTE IMMEDIATE
客户端生态
databend-jdbc
v0.4.9
v0.4.10
v0.4.9
v0.4.10
bendsql
新特性的使用场景
高频查询与公共中间结果复用
如果多个报表或下游任务反复执行相同的单表聚合,可以评估使用物化视图持久化查询结果。增量刷新、混合读取和查询改写能够减少重复扫描与计算,降低高频分析对源表的压力。
对于多表 Join 产生的派生结果,可以评估 Dynamic Table。它适合能够接受显式刷新周期,希望将复杂查询结果保存下来供后续任务重复读取的场景。
跨租户数据协作
当同一 Databend Meta 集群中相互隔离的租户需要使用同一份业务数据时,Data Sharing 可以让消费方直接读取提供方授权的 Fuse 表,减少数据导出、重复副本和同步任务。
消费方还可以在共享表上创建本地 Stream,按照自己的处理周期消费增量。这种方式适合将共享明细接入本地数据处理流程,再生成报表或派生表。Stream 负责记录消费进度,具体的数据处理任务仍需单独配置。
异常溯源与变更影响分析
当数据模型已经形成较多上下游依赖时,数据血缘可以帮助开发和运维人员定位异常指标的来源,也可以在修改表或列之前查看可能受影响的下游对象,缩小排查和回归验证范围。
血缘采集采用异步、best-effort 机制,可能因历史配置或处理失败而出现缺失,因此适合作为排查和影响分析工具,不能替代完整的审计记录。
查询效率与运行稳定性
Fuse 分区、TopN 和索引相关改进适用于扫描量较大、排序取前 N 条以及多语言全文检索等查询。资源回收和内存控制方面的修复,主要改善大查询、查询取消和客户端提前断开等情况下的资源释放与执行稳定性。
实际收益会受到数据布局、查询条件和执行计划影响,建议结合生产负载进行验证。采用新功能前,还需核对版本、授权和功能限制,并在升级前检查已经移除的旧能力。
升级注意事项
本期产品更新移除以下能力。使用相关功能的部署应在升级前完成依赖盘点与兼容性验证:
-
Aggregating Index:相关能力方向转向物化视图。需重新评估定义、授权与刷新策略,原索引不会自动迁移。
-
PROXY table engine:原有能力方向由物化视图替代。
-
Hive Catalog:本期移除, Hive 表及生态越来越少。
-
Lance unload 支持:历史元数据保留兼容解码,但实际 Lance 格式数据访问将返回不支持错误,需改用受支持格式。
-
只读
表引擎:不再支持新建语法,已有此类表升级后访问将失败。ENGINE = DELTA
上述调整减少了重复实现与依赖负担,同时涉及既有系统的兼容性。建议结合目标版本 release notes,完成迁移评估与回归测试。
访问 Databend GitHub(databendlabs/databend)和产品文档(docs.databend.cn),查阅 Release Notes,了解更多产品特性和使用方法。
订阅我们的新闻简报
及时了解功能发布、产品规划、支持服务和云服务的最新信息!