 evot.ai

PASS 率看不到 Trace 里的路径差异
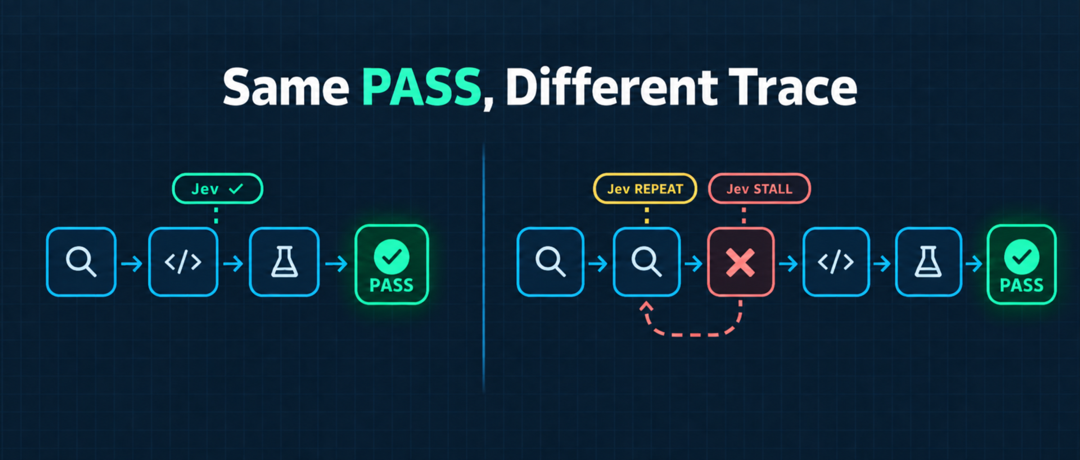
团队常用的 Agent Evals 会固定任务集和 Agent,只更换底层模型运行同一批测试用例。表面结果经常相差不大,测试都能通过,最终 patch 有时甚至逐字节相同。团队仍然需要知道,新模型是否减少了请求和空转,又从哪一步开始偏离任务。
这些差别不会写在 PASS 率里。它们留在 Trace 中,一条会话按 span 展开,往往有几十到上百步。调用了什么工具、读过哪些文件、什么时候开始重复动作,都要回到这些步骤里看。
这次实验同时比较了模型与 harness。先把实验对象和任务交代清楚,后面的成本与路径数据才有参照。
三种 Agent 运行同一个修复任务
这里的 Agent 包含模型之外的执行框架,文中也称为 harness。同一个模型放进不同 harness,能够调用的工具和拿到的上下文会发生变化,执行路径也会跟着改变。
实验选了三种设计思路不同的终端 Coding Agent。
| Agent | 基本设计 |
|---|---|
| Evot | 尽量少在模型外增加干预,系统上下文约为 1K token,默认提供 |
| Pi Coding Agent | 轻量终端 harness,默认工具集与 Evot 接近。开发者可以用 TypeScript 扩展、skills、prompt 模板和 packages 组合工作流。 |
| DeepSeek Harness | 简称 DSH,采用 Everything is a plugin 的设计。模型适配器和工具可以替换,沙箱、存储、会话与 Agent 循环也可以更换。 |
三种 Agent 接到同一个任务,修复
serde-rs/json
EnumAccess.variant
{[true]: null}
任务提示已经给出根因位置和修复方向,并明确要求先查看下一个非空白字节,再决定进入哪个分支。Agent 需要修改实现、补回归测试,随后跑过完整测试。验证阶段保持离线,依赖在 Agent 启动前准备好。这样可以收窄信息来源,减少网络和依赖变化对结果的干扰。
Trace 已经能快查,逐 Span 判断仍然太贵
Databend 已经可以处理 Trace 数据。海量 Trace 以适合保存半结构化 JSON 的 VARIANT 类型落地,再由 Stream 捕获增量、Task 定期加工,在库内形成
traces
trace_id
SQL 能告诉我们某一步调用了什么工具、花了多少 token。另一些问题需要理解上下文,例如这一步有没有推进任务,或者是否在重复刚才的动作。
行业里常用 LLM-as-Judge 处理这类问题。做法是把上下文交给通用模型,让它写评语并返回 JSON。按约 2k 输入 token 和 300 输出 token 估算,GPT-4.1 mini、Claude Haiku、Gemini Flash 这一价格区间的模型,每个 span 约需 0.001 到 0.0035 美元,延迟约为 1 到 3 秒。模型价格会变化,实际部署仍需按当期版本重新核算。
一天产生一百万个 span,评审成本会达到一千到三千五百美元。团队往往只能抽查,判定结果也很难和 Trace 一起在同一个数据系统里持续积累。
湖仓已经能快查,Evals 还缺一种快速且低成本的语义判定。
Jev 把 Judge 从写评语改成勾选题
卡尼曼在《思考,快与慢》中区分了系统一和系统二。系统一处理快速、直觉式的判断,系统二负责较慢的推演。可以把写代码和做规划的主模型类比为系统二。判断某一步是否与任务相关,或者有没有重复刚才的动作,更接近一组边界清楚的勾选题。
TypeSafe 借用了这套划分,把这类模型称为 System One Models。首个模型 Jev 的名字则来自经济学家 William Stanley Jevons。
Jev 不生成开放式长文,它只回答预先定义的结构化问题。Choice 从给定选项中选择答案,Score 按给定等级打分,Noul 返回命题成立的概率。Choice 和 Score 还会返回置信度,schema 则限制了答案的类型。一份材料可以附上多道题,在同一个请求中提交。
按照 TypeSafe 发布时的公开信息,Jev 的输入价格为每百万 token 0.042 美元,输出免费,端到端响应通常落在 70 到 500 毫秒。Jev 当时仍处于 early access,具体配额与可用性需要以实际账号为准。
用 LLM-as-Judge 像请专家逐条写评语。Jev 更像一份结构化问卷。逐 span 评测通常用不到长篇解释,问卷式结果已经能够进入后续分析,成本也能降低一个数量级以上。
一条 Span 怎样完成判定
一部分事实可以由代码直接确定。文件是否属于任务范围、验收是否发生在最后一次改动之后、当前工具调用是否和前一步重复,都可以先算出来。
需要理解上下文的部分再交给 Jev。它可以给相关度打出 0 到 4 分,并判断当前 span 有没有带来新进展、是否触及已知根因。违规行为和收尾阶段是否缺少测试证据,可以分别设置成独立问题。
这里需要区分两种根因任务。Jev 可以判断当前 span 是否触及预先定义的根因,开放式根因分析仍要交给通用模型或人工处理。
答案和代码算出的事实对不上时,系统把它标记为
unsure
判定写回 Databend,分析继续使用 SQL
我们把 Jev 接在
traces
span_judgments
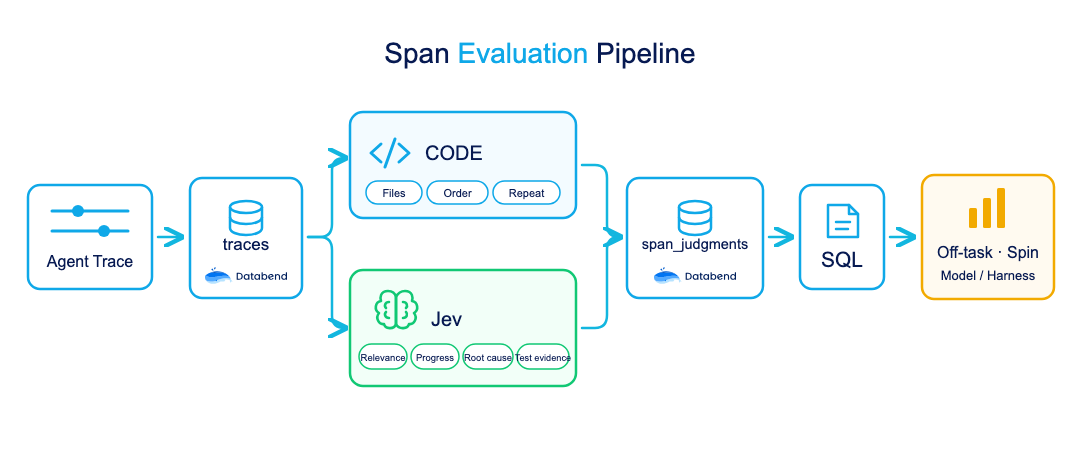
判定落库以后,跑偏率、打转率和模型对比就能继续使用 JOIN 与 GROUP BY。团队不用另外维护一套与 Trace 分离的评审系统,还可以沿着 session 和 span 回到原始上下文。
1,171 个 Span 的实测成本
trace.evot.ai 收录了 50 条评测会话,共包含 1,171 个 span。这些会话来自多组模型与 harness 组合,本文选取模型对比和 harness 对比两个切片,完整运行记录可以在评测页面中查看。
Jev 的实测成本约为每个 span 0.00008 美元,批量请求的中位延迟约为 410 毫秒。对照组采用 LLM-as-Judge 快速档,估算成本约为每 span 0.001 到 0.0035 美元,单个 span 延迟约为 1 到 3 秒。
两个延迟数字的口径不同。410 毫秒是 Jev 批量请求的中位数,1 到 3 秒是通用 Judge 的单 span 估算。它们可以说明量级差异,严格的端到端对比仍应使用相同的批量大小和并发条件。
| 规模 | Jev | LLM-as-Judge,按 0.002 美元每个 span 估算 |
|---|---|---|
| 100 个 span,一条长会话 | 0.008 美元 | 0.20 美元 |
| 10 万个 span | 8 美元 | 200 美元 |
| 100 万个 span | 80 美元 | 2,000 美元 |
| 1 亿个 span | 8,000 美元 | 200,000 美元 |
| 按 5% 抽样 500 万个 span | 400 美元 | 10,000 美元 |
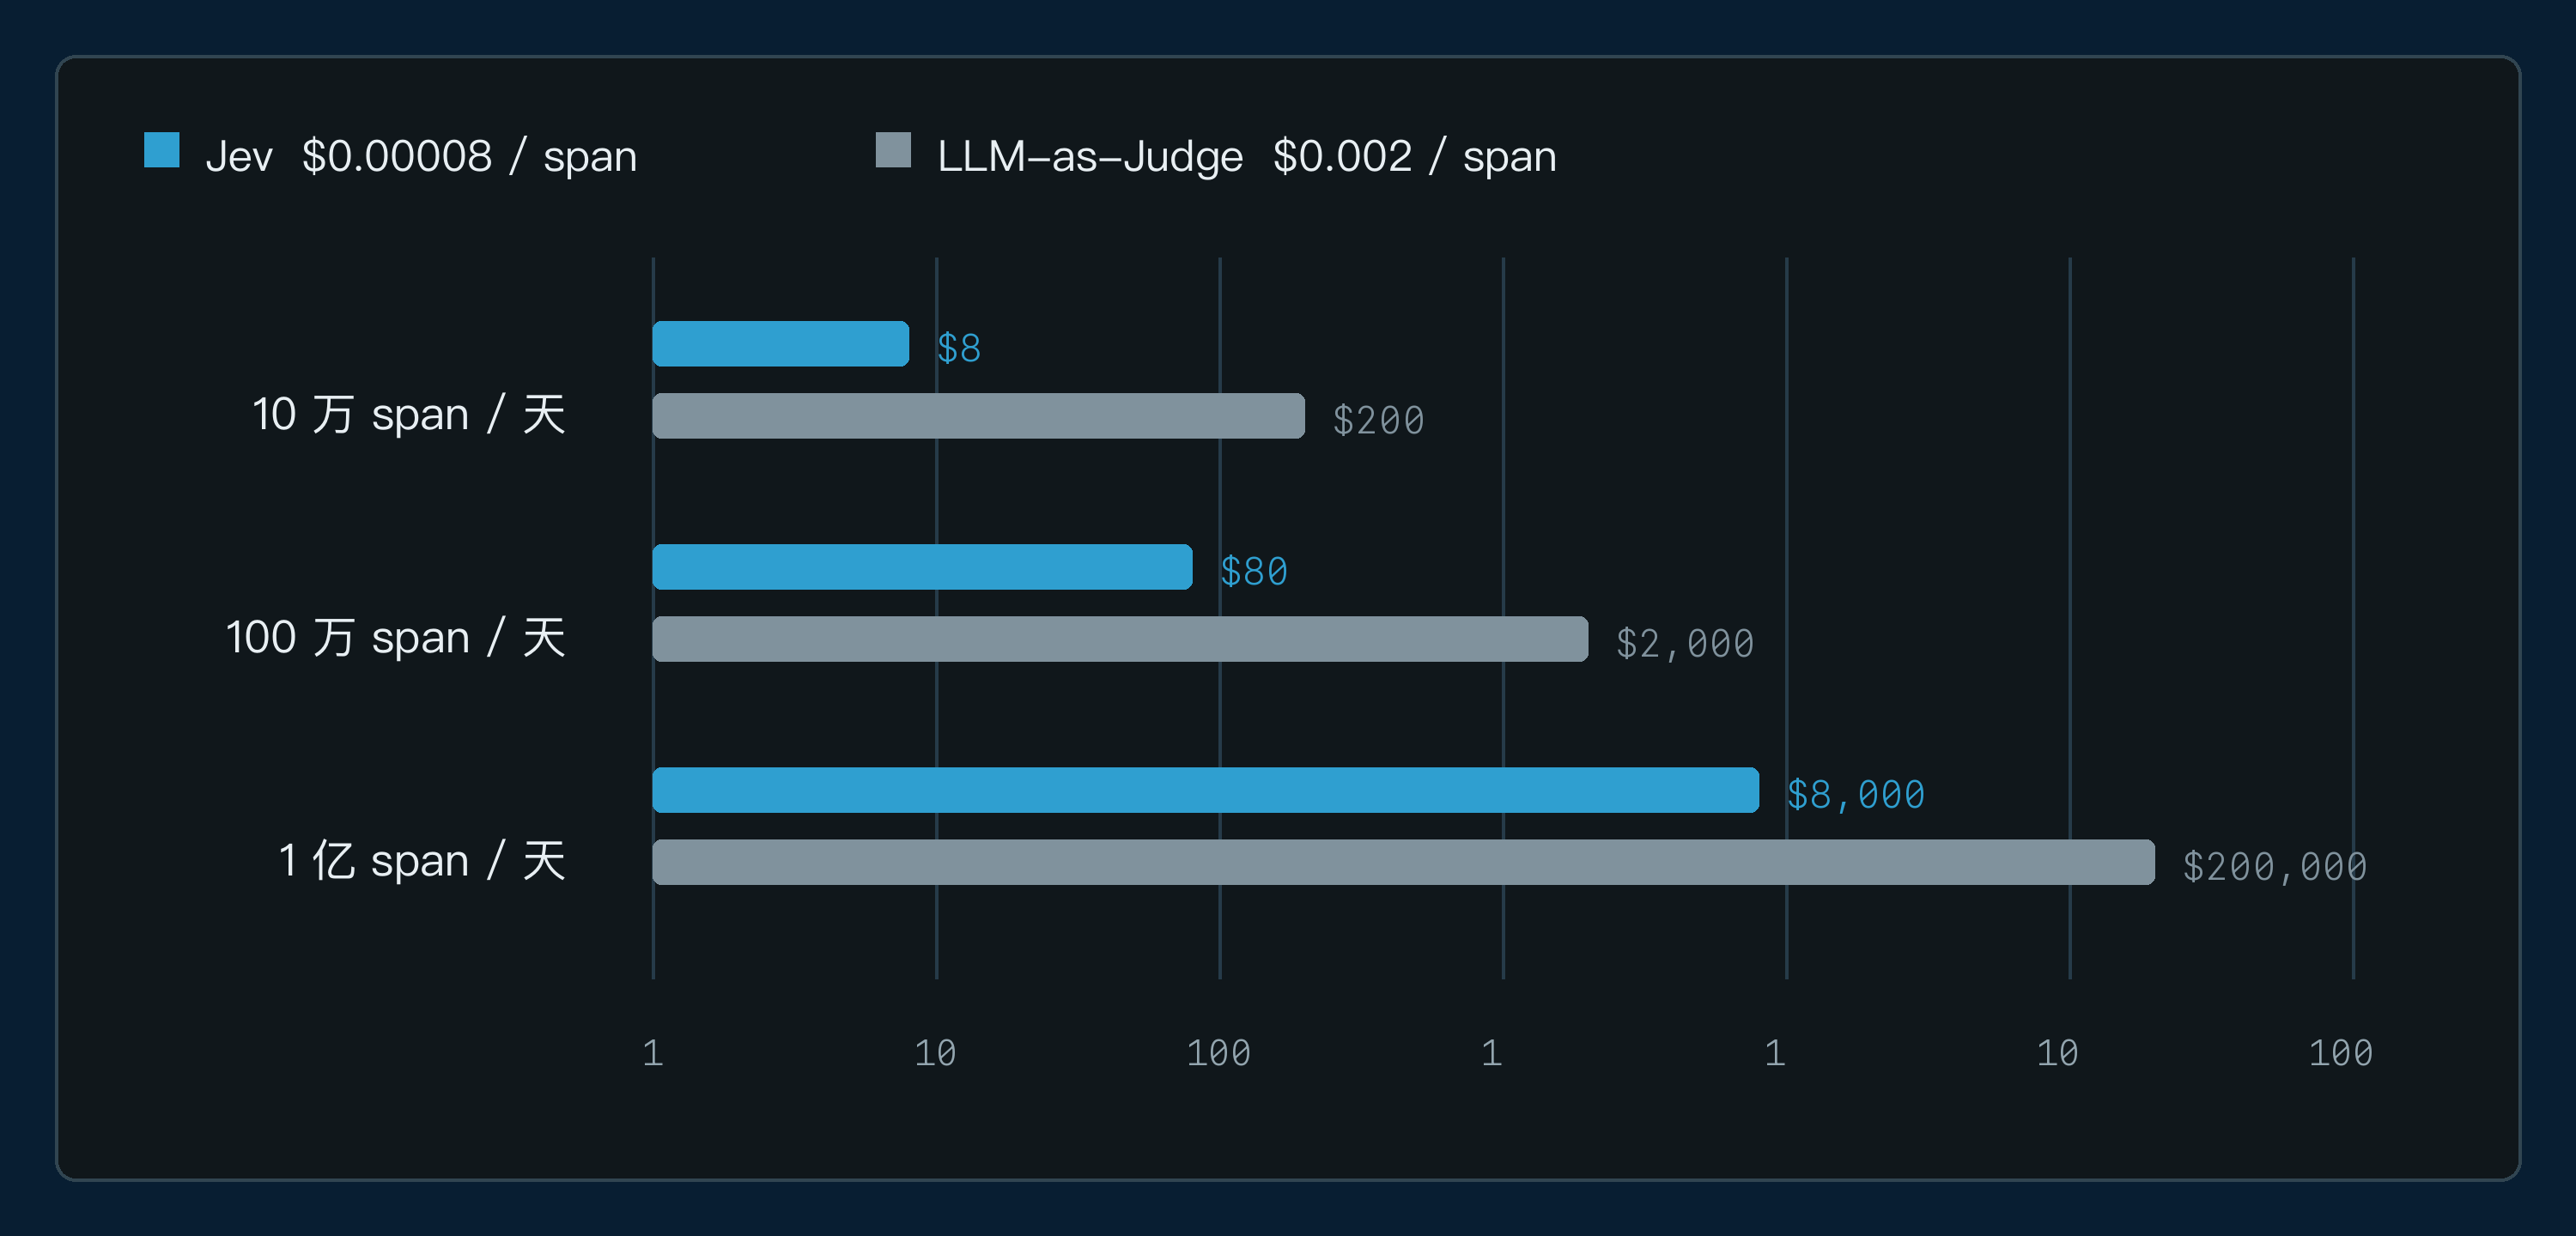
每天不超过一百万个 span 时,全量判定大致需要几十美元。规模继续增加,可以先用 SQL 分层抽样,优先覆盖失败会话和超长会话。并行请求拉满以后,瓶颈通常落在 API 配额上。
同样通过任务,路径质量仍会拉开
此前的一组实验比较了不同模型。同一个
serde_json
换模型或调整 prompt 时,这类差异比最终 PASS 更能说明过程质量。
run-199 展示了另一种切片。这里固定同一个
glm-5.3-flash
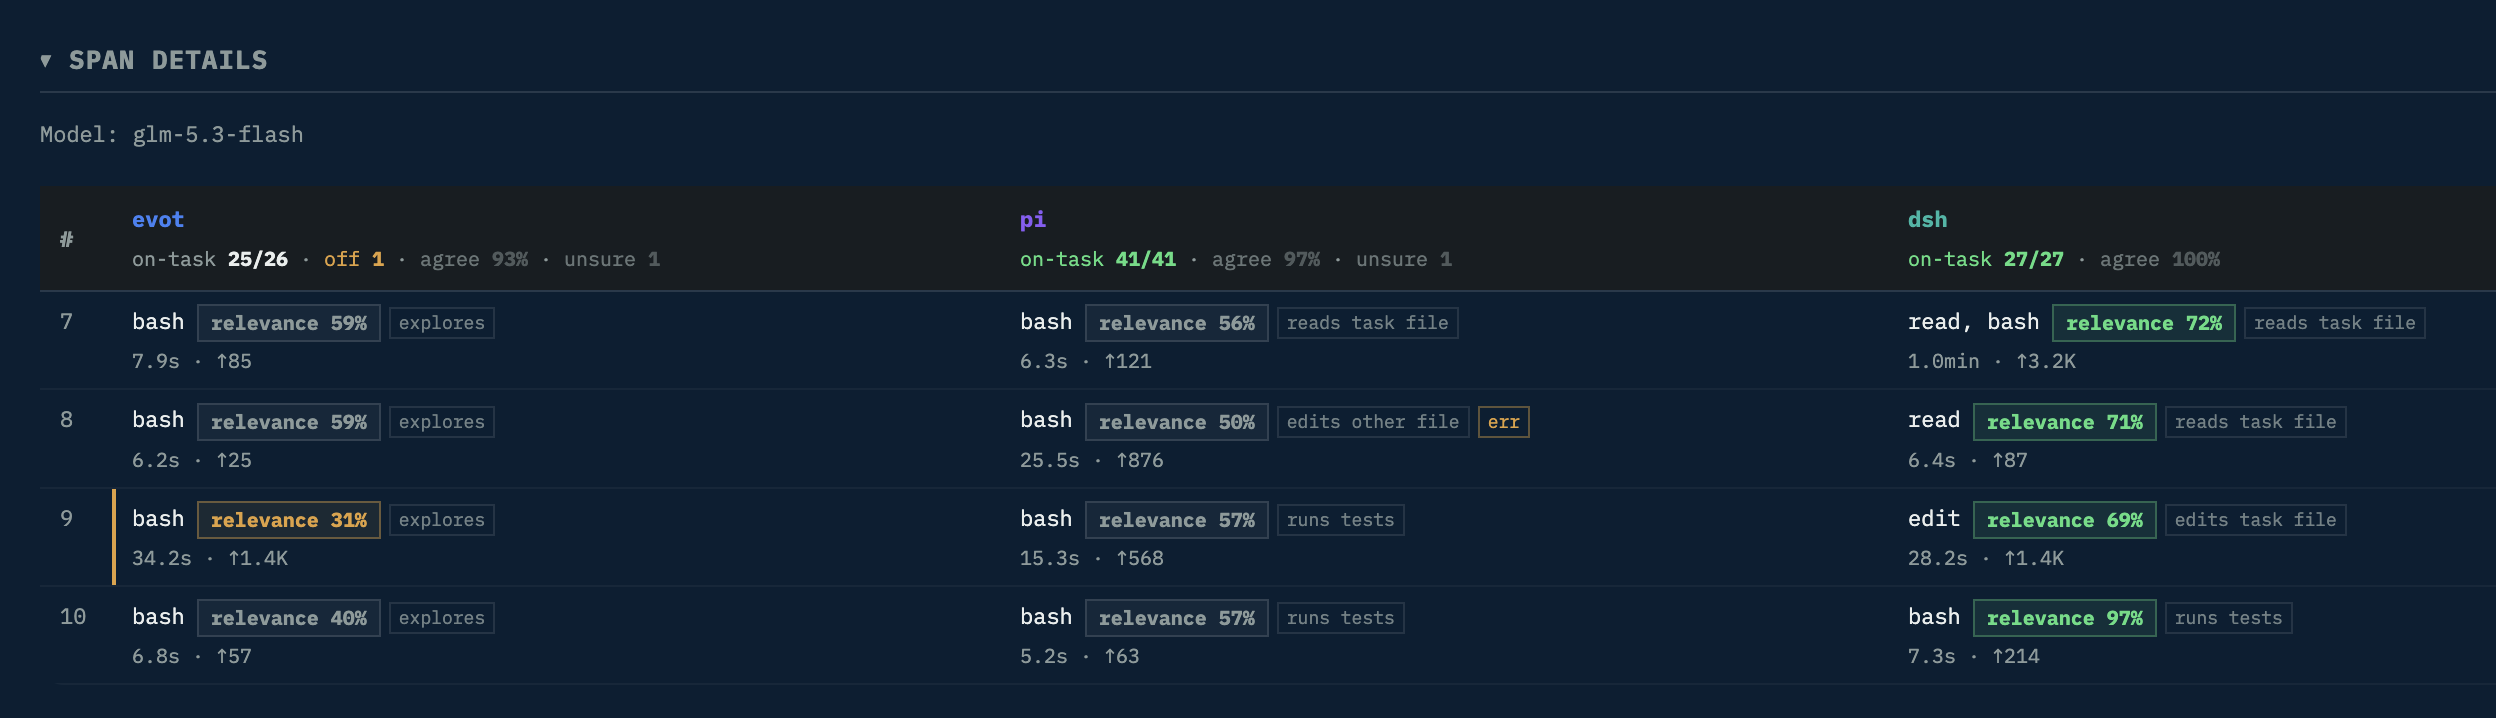
| Harness | 请求数 | 耗时 | 判定标出的无新进展 |
|---|---|---|---|
| evot | 26 | 479 秒 | 1 处 |
| pi | 41 | 696 秒 | 2 处 |
| dsh | 28 | 403 秒 | 1 处 |
三种 harness 都完成了任务。pi 使用了 41 次模型请求,比 evot 多 15 次,比 dsh 多 13 次,耗时也最长。逐 span 的判定进一步标出了两处没有带来新进展的步骤。最终结果仍然是 PASS,这些过程差异只有展开 Trace 才能看见。
判定写入
span_judgments
relevance
necessary
SELECT t.model, t.harness,
       avg(j.relevance) AS avg_relevance,
       countIf(j.relevance < 1.5) / count() AS off_task_rate,
       countIf(j.necessary < 0.5) / count() AS spin_rate
FROM span_judgments j JOIN traces t USING (session_id)
WHERE j.kind = 'judged'
GROUP BY 1, 2
ORDER BY off_task_rate DESC;
这套方法的应用
Jev 适合目标清楚、答案范围预先定义的判断。开放式根因分析和复杂推演仍要交给通用模型或人工处理。问题怎样写、分数怎样定义,也会直接影响最后得到的指标。
能够由代码确定的事实应当继续交给代码。Jev 补上规则难以覆盖、又不需要长篇生成的语义判断。低置信度和
unsure
这套分工扩大了可覆盖的 span 数量,也让判定结果能够和原始 Trace 放在一起检查。Judge 的误判依然存在,团队仍需抽样复核。
本文的实测主要覆盖成本和延迟,还没有给出 Jev 与人工标注或通用 Judge 的一致率。现有数字可以说明逐 span 判定变得更可负担,暂时不能用来判断哪一种 Judge 更准确。真正接入生产流程以前,团队还需要抽样复核,并用自己的标注数据校准问题和阈值。
本文的实测主要覆盖成本和延迟,还没有给出 Jev 与人工标注或通用 Judge 的一致率。现有数据可以说明逐 span 判定变得更可负担,尚不足以判断哪一种 Judge 更准确。接入生产流程以前,团队需要用自己的标注数据校准问题与阈值,同时评估 early access 服务的配额和可用性。
让逐 Span 的判定变得可负担
Databend 负责保存和分析 Trace,Jev 处理边界明确的语义问题,普通代码计算能够确定的事实。结果回到同一个湖仓以后,模型对比、harness 对比和分层抽样仍然可以用 SQL 完成,后续也能据此筛选训练数据。
PASS 告诉团队任务有没有完成。逐 span 的判定进一步说明任务是怎样完成的,以及成本花在了哪里。
相关资源
推荐阅读:https://mp.weixin.qq.com/s/OjWTtUFTydr7O_FSzygyMA
订阅我们的新闻简报
及时了解功能发布、产品规划、支持服务和云服务的最新信息!